
科技云报到原创。
AI正在打开数据库更大想象力。
对于数据库而言,AI带来的不只是一个新的应用场景,而是一个比传统数据库更大的增量空间。IDC预测,AI驱动的软件架构将撬动未来万亿美元级的企业IT预算重构。
当AI深度渗透企业核心业务系统,不少企业陷入两难:既期待借助AI实现业务效率跃升,又不愿对现有业务体系做大规模重构。
在原有架构上不断堆砌向量检索、知识库等新增组件,反而催生新的数据孤岛,数据一致性、查询性能、建设成本等一系列现实挑战接踵而至。
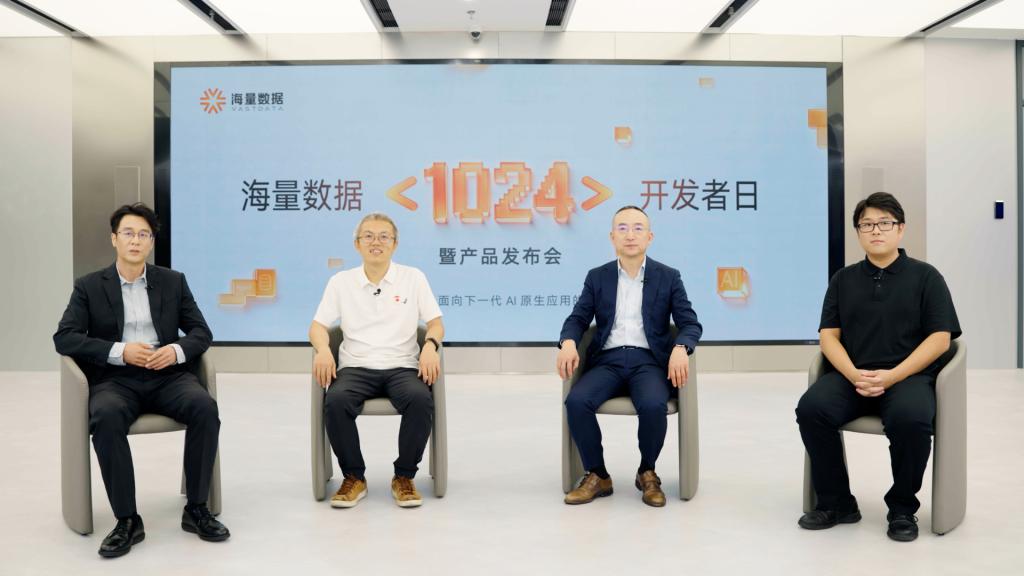
AI时代的数据基础设施到底该如何建设?10月24日,海量数据1024开发者日暨产品发布会如期举办,学术界、产业界与权威研究机构多方共聚,共同探寻下一代AI原生数据基础设施的建设路径。
AI浪潮下
数据库站在变革交汇点
IDC中国王楠分享了IDC对于AI数据基础设施市场的最新洞察。
根据IDC研究,2025‑2030年中国AI数据基础设施市场复合增速将达到37.7%,2030年市场规模可达738亿美元;到2035年,市场规模有望进一步达到1548亿美元,较2025年增长超10倍,规模可观的增量市场正加速孕育。
过去几年,AI产业的竞争主要围绕模型和算力展开。但随着大模型通用能力快速提升,企业真正面临的瓶颈开始从模型够不够强,转向企业数据能不能被AI真正用起来。
当前绝大多数企业业务场景,大模型本身的能力已经基本够用,如今阻碍AI产生业务价值的,正在变成数据能力。
AI要想真正扎根产业,数据基础设施的建设必须走在前面。作为数据的关键载体,数据库正迎来全新挑战。
这种挑战并非简单地新增一项功能,而是要求数据库在保障核心业务稳定运行的基础上,具备处理复杂多类型数据、承接更高算力需求的综合能力。
数据不仅要存得下,还要能够被统一管理、实时检索、理解和调用,并在整个过程中满足安全与合规要求。
为此,满足AI时代的数据库绝不能是在传统数据库上简单地外挂向量插件、堆砌AI功能,而必须同时承接两大命题——既要守住核心业务系统的稳定性、事务一致性、安全合规底线;又要内生多模态、语义理解、智能体记忆与调度等各项AI能力,让原有业务数据无需大规模迁移,即可直接释放AI价值。
数据智能北京市重点实验室主任、清华大学李国良教授在圆桌对话中指出,“数据库已经走过单机、分布式、云原生阶段,正在从‘存储和查询数据的系统’,演变为‘支撑智能体感知、记忆、推理与行动的数据底座’,这很可能是继分布式和云原生之后,数据库发展的下一个重要阶段。”
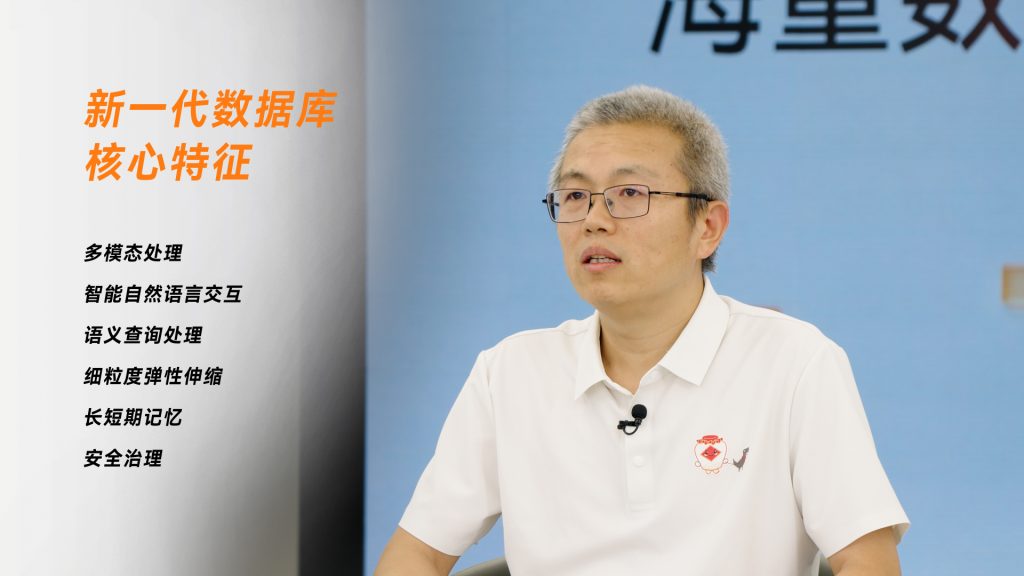
数据智能北京市重点实验室主任
清华大学 李国良教授
在AI的全新周期,数据库如果仅仅叠加向量检索能力,只能解决部分知识库检索场景,却无法适配企业核心生产系统。
下一代AI原生数据库需要具备多模态统一处理、自然语言交互、语义事务、细粒度弹性伸缩、长短期记忆、全链路安全治理六大核心特质,这也构成了其有别于传统数据库的基础能力框架。
- 多模态统一处理:原生兼容结构化与非结构化数据,深度融合SQL、全文、向量、图检索能力,支持以自然语言直接访问、查询数据;
- 自然语言交互:可深度理解业务目标与用户意图,不止输出查询结果,还能自动生成执行操作、输出可解读说明,全部行为受权限与合规体系严格约束;
- 语义事务:在传统ACID事务基础之上,针对AI长周期任务新增语义一致性、状态管理、补偿回滚、并发隔离能力,实现AI业务操作可验证、可干预;
- 细粒度弹性伸缩:针对访问请求、业务租户、AI Agent、独立任务实现资源精细化调度,平衡系统运行稳定性与整体资源利用率;
- 长短期记忆能力:为AI智能体提供短期上下文记忆与跨任务长期记忆,支持信息的压缩与迭代更新,配套权限隔离以及完整的生命周期管控;
- 全链路安全治理:将安全治理边界延伸至AI智能体行为层面,具备细粒度权限管控、操作审计溯源、敏感数据保护能力,高风险操作可触发二次授权确认,提供回滚机制确保可控。
李国良将AI原生数据库的核心价值归纳为三点:让机器能够理解数据,让Agent可以记忆并调用数据,保障智能体的每一步操作安全、可靠且高效。
真正的AI原生数据库,追求的是传统业务负载与AI智能负载的共生共存,而非两套系统相互割裂、分头建设。这也恰恰是当前企业选型数据库时最现实的诉求:市场需要的是一套能够兼容现有业务体系、同时原生内置AI能力的数据库产品,以此规避重复建设,守护企业长期沉淀的数字化资产。
AI重构数据库内核
在产业土壤长出智能
理论层面勾勒出AI原生数据库的理想范式,但学术构想终究需要产业落地承接。
如何把六大核心特质转化为可落地、可商用的数据库能力,实现存量核心业务与AI新业务的一体化运行,也正是海量数据1024开发者日所要回答的产业命题。
从传统数据库到AI原生数据库,变化的并不只是产品形态,更是数据基础设施的价值边界。
过去,数据库主要服务企业业务;随着多模态数据底座成为企业走向数据智能的重要路径,数据底座也将进一步服务AI。
面对席卷而来的AI浪潮,行业客户的矛盾心态十分普遍,对AI抱有极高期待,却畏惧改造复杂度、改造成本,无法停下现有核心业务,也不愿再搭建一套割裂的AI数据体系。
海量数据董事长、总裁肖枫,从数千家一线客户真实痛点出发,解读AI落地的现实困境。
肖枫表示,AI数据体系改造的复杂度、成本、业务认可度都是摆在企业面前的现实难题。
大量AI应用不是从零新建,而是要在原有数据、业务流程基础上迭代升级,这就要求数据库既要承接传统业务规则,又要具备语义理解能力,打通传统业务向AI原生应用的演进桥梁。
海量数据董事长、总裁 肖枫
作为国产数据库头部厂商,海量数据库累计服务超4000家客户,深度覆盖政务、制造、金融、通信、能源、医疗、交通等关键行业,已经成为国产数据库首选之一。IDC发布《中国本地事务型数据库市场份额,2025》报告显示,海量数据库已成功跻身数据库市场Top10,是国内事务型数据库市场的核心推动者之一。
为攻克AI时代数据库技术难题,海量数据与清华大学、清华工业开发研究院三方共建的数据智能北京市重点实验室,打通产学研链路,把前沿学术研究转化为产品能力。
本次发布会正式对外发布了海量数据库两大关键升级:向标联合、多模协同。依托“多模原生,融算一体”的产品路线,完成从数据承载平台向AI原生智能数据基座的演进。
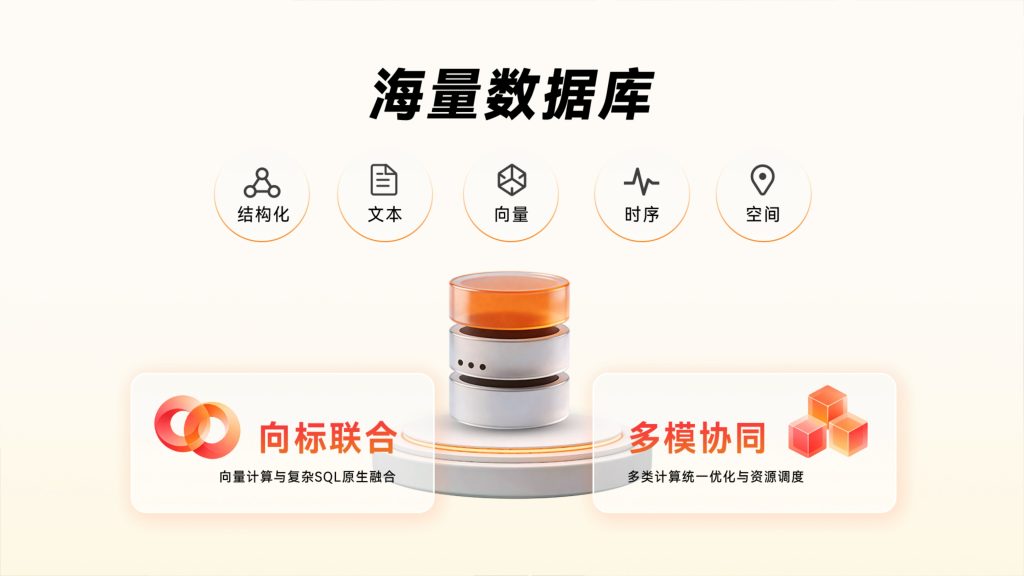
传统向标联合方案,仅能在向量检索前后增加静态过滤条件,面对多表关联、多重业务规则的复杂查询,向量检索和关系查询会互相割裂。
海量数据库依托多模原生内核重构查询执行策略,将向量算子与筛选、关联、排序、聚合整合进同一条SQL执行链路,实现语义检索和业务查询原生协同。
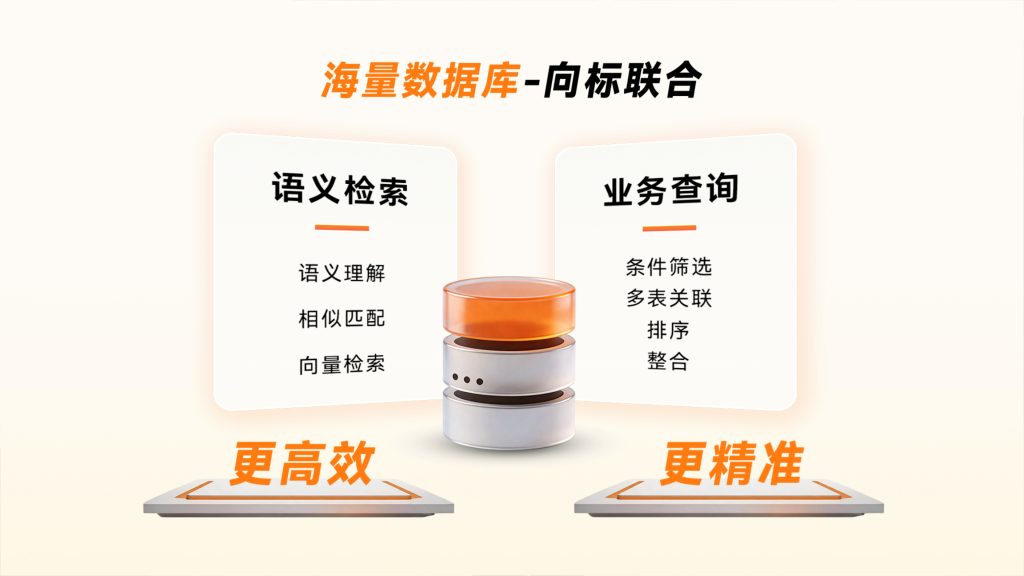
在与医院联合共建的康复诊疗系统场景中,面对规模达400万条的病例数据库,仅通过单条SQL语句,即可同步完成病例向量语义匹配、多表关联查询、业务条件过滤与结果排序。
实测查询延迟下降46%,检索精度稳定保持在99%以上,整体业务效率实现翻倍,助力医生快速筛选具备参考价值的真实病例,有效破解医疗行业复杂多条件检索的现实痛点。
多模态场景下,不同类型计算容易带来数据搬运、资源争抢,造成性能损耗。海量数据库从执行策略、资源调度两大维度完成优化。
执行策略层面,将多类计算纳入统一优化器,依据数据规模、条件选择率动态规划执行顺序;依靠自适应标量选择率,根据业务条件判断先过滤还是先检索,自动选择代价更低的执行路径,同时搭配动态检索终止机制,减少无效搜索,使检索速度提升约40%。
资源调度层面,通过VectorBuffer与SharedBuffer双缓存动态分配内存、SIMD指令集并行加速、PQ/RabitQ量化压缩,实现内存、CPU、存储统一管控。
实测百万级混合检索场景,QPS突破1万,召回率稳定99%以上,磁盘占用降低约75%。
海量数据库在多模协同计算方面的性能提升,保障了高并发大规模业务场景下的高性能、低资源消耗,形成面向生产环境的持续承载能力,让多模态能力真正走进核心生产系统。
夯实底层核心能力
支撑上层业务创新
肖枫在分享中表示,AI浪潮正在重塑基础软件行业格局,过往数十年沉淀形成的技术壁垒被重新打破,为国内厂商创造出与国际巨头站在同一起跑线竞争的历史性机遇。
数据库作为核心基础软件,是我国AI产业在全球竞争中抢占先机、构建差异化优势的关键基石。
对于海量数据而言,AI并不是在传统数据库之外重新开辟一条业务线,而是让原有的数据基础设施能力进入更大的市场,在现有成熟的数据底座之上生长出原生的智能化能力,既扛住企业核心业务的重压,又承载AI时代层出不穷的创新诉求,搭建起从过去传统应用到下一代AI原生应用的关键性桥梁。
毫无疑问,谁能解决好AI与产业的关系,谁就能拿到下一代数据基础设施的入场券,未来AI数据基础设施市场的竞争,在于谁能够率先形成覆盖“数据管理-数据智能-数据服务”的完整闭环。
而这正是当下基础软件向上突围的时代命题。
【关于科技云报到】
企业级IT领域Top10新媒体。聚焦云计算、人工智能、大模型、网络安全、大数据、区块链等企业级科技与数字化转型与赋能的领域。原创文章和视频获工信部权威认可,是世界人工智能大会、数博会、国家网安周、可信云大会与全球云计算等大型活动的官方指定传播媒体之一。